

Moin AInauten,
Willkommen zur neuen Ausgabe deines Lieblingsnewsletters.
Spannende Woche wieder. Bei Nvidia gibt es Affären mit Spionageverdacht (und vielleicht bald einen neuen CEO?), während sich bei Anthropic und OpenAI der große Showdown anbahnt.
Anthropic hat kurz vor dem Börsengang Fable 5.2 rausgebracht und will sich damit als Nummer 1 zeigen. OpenAI wartet wohl nur auf den passenden Moment, um mit ihrem neuesten Modell die Party zu crashen…
Wir haben uns Fable 5.2 natürlich direkt geschnappt und wie immer geschaut, was es für Normalos wie uns bringt. Ehrlich gesagt: ziemlich beeindruckend.
Und weil gerade alle nur auf die ganz großen Modelle schauen, haben wir zum Schluss noch ein ganz kleines dabei. Das Training des Modells hat nur 57 Dollar gekostet und bei einer Sache hängt es die Großen trotzdem ab.
Hier die Themen im Detail:
🧪 Fable 5.2: Das beste AI-Modell zerlegt unsere eigenen Projekte
🧠 Ein Gehirn für alle deine Agents kinderleicht aufgesetzt
🎯 Klein schlägt groß: Das 57-Dollar-Modell
Los geht's!
🧪 Vibe Check: Fable 5.2 zerlegt unsere eigenen Projekte
Yay, schon wieder ein neues Modell! Aber eines der ganz wichtigen, weshalb wir es hier direkt als Allererstes aufgreifen.
Vor zwei Wochen haben wir den Vibe Check eingeführt, bei dem wir neue Modelle an Alltagsaufgaben messen. Jetzt hat Anthropic die „neuen, besten“ Modelle Claude Fable 5.2 und Mythos 5.2 vorgestellt. Dafür reicht ein kleiner Vibe Check nicht mehr aus.
Daher diesmal mit zwei Tests. Unser festes Test-Set kommt weiter unten. Vorher zeigen wir dir einfach mal, was wir mit jedem neuen smarten Modell als Erstes machen. (Und was du auch gleich machen kannst, weil es so wertvoll ist.)

In einem Satz: Anthropics neues Top-Modell ist für die richtig dicken Bretter. Für den Alltag empfiehlt Anthropic selbst weiterhin Opus 5.5.
Aber Fable 5.2 ist wirklich extrem smart. Und im Pro-Abo ist es aktuell sogar zum Ausprobieren mit dabei, mehr dazu weiter unten.
Was sonst neu ist:
Fable für alle, Mythos für wenige: Im Kern ist es dasselbe Modell. Fable hat Sicherheitsbremsen bei Cybersecurity und Biologie eingebaut. Den Zugang zu Mythos mit weniger Bremsen bekommen nur geprüfte Organisationen.
Schneller und günstiger: Bis zu 30 % schneller als der Vorgänger. Über die API kostet es 8 Dollar pro Million Input-Token und 40 für Output, vorher 10 und 50.
Eine Stufe über Opus 5.5: Wir lieben Opus 5.5, aber Fable 5.2 setzt gerade zum Überholen an, besonders wenn es um herausfordernde Aufgaben geht.
Unser Lieblingstest
Benchmarks sagen uns ehrlich gesagt wenig. Wir wollen wissen, ob das neue Modell uns persönlich etwas bringt. Also bei unseren Projekten und in der täglichen Arbeit.
Deshalb setzen wir jedes neue Modell in unser Second Brain (Claude Code, mit Zugriff auf alle Notizen, Projekte und die echten Zahlen aus Google Ads & Co.) und stellen genau eine Frage:
Schau dir die drei Projekte an, an denen ich in den letzten Tagen am meisten gearbeitet habe.

Analysiere sie genau: Sind sie ideal aufgesetzt? Mache ich alles richtig? Wo verschenke ich Umsatz, Gewinn oder Mehrwert?

Verlass dich nicht auf meine Notizen, sondern prüf die echten Zahlen nach. Sag mir ehrlich, was du anders machen würdest, auch wenn es weh tut.
Wir sagen ihm nicht, welche Projekte das sind, wo die Daten liegen usw. Das muss es selbst rausfinden. Und weil es unsere Projekte sind, merken wir sofort, ob es Quatsch erzählt.
Das geht übrigens auch ohne Second Brain. Dann legst du die Unterlagen zu deinen Projekten einfach in ein Projekt in Claude oder ChatGPT und setzt es darauf an.
Was dabei rauskam
Ganz ehrlich, das tat etwas weh.
Projekt 1: Ein neues AInauten-Produkt, an dem wir arbeiten
Die letzten Tage haben wir an einem neuen Produkt für die AInauten gearbeitet, das 2027 erscheinen soll.
Strategie, Aufbau usw.: Alles stand. Fable hat es auseinandergenommen und nach ein, zwei Stunden war es komplett entschlackt, durchgetestet und deutlich besser und smarter aufgestellt.

Spannend, denn AI-Modelle sind normalerweise nicht dafür bekannt, Content schlanker und präziser zu machen.
Projekt 2: Lead-Kampagnen, die seit Monaten profitabel laufen
Das zweite Projekt, das sich Fable angeschaut hat, waren Google-Werbekampagnen. Wir haben hier über Monate extrem optimiert und sind auf der Suche nach zusätzlicher Marge.
Neben weiteren Optimierungen hat uns Fable Microsoft Ads gepitcht und gleich einmal Volumen und potenzielle Marge analysiert.

Normalerweise hätten wir immer nein zu Microsoft Ads gesagt, weil dort nicht so viel Suchvolumen ist.
Fable hat uns überzeugt, es mitzunehmen, und ’ne Stunde später war es aufgesetzt...
Das war für uns auch wieder ein wichtiges Learning: Früher hätte man solche Dinge nicht unbedingt gemacht, weil sich der Aufwand oft nicht gelohnt hat. Mit AI ist das alles kaum noch Aufwand. Die Kosten sind gering, daher kann man auch unzählige kleine Dinge machen.
Zusammen ergeben viele kleine Dinge dann auch manchmal etwas Großes.
Wo es daneben lag
Behauptet auch mal Unsinn. Es hat uns mit voller Überzeugung erklärt, in ChatGPT gäbe es keine Skills. Natürlich gibt es die! Nicht nachgeschaut, einfach behauptet.
Leider immer noch nicht kreativ genug. Wir wollten Prompts für kreative Buch-Cover, die auch verkaufen, inkl. Titel und Subheadline. Leider waren wir hier nicht wirklich zufrieden.
Beim Analysieren und Nachrechnen ist es wirklich krass gut. Kreativ noch nicht so.
Und unser festes Test-Set?
Haben wir natürlich auch laufen lassen. Dieselben fünf Alltagsaufgaben wie immer: Spesen, Vertrag, Shop-Zahlen, Fangfragen, LinkedIn-Post.

Fable macht alles richtig. Auch den Rechenfehler im Vertrag, an dem Opus in unserem ersten Test zweimal gescheitert ist, findet es in allen drei Läufen.
Aber für diese Aufgaben kostet es fast doppelt so viel wie Opus und ist kaum schneller. Beim LinkedIn-Post landet es gleichauf mit Opus.
Für Alltagskram also ziemlich überdimensioniert. Sagt Anthropic ja auch selbst.
Nimm es für große, offene Aufgaben, bei denen das Modell selbst Daten ziehen, prüfen und rechnen soll. Analysen, Audits, „schau mal über alles drüber“.
Lass es bei schnellen Alltagsaufgaben. Da reicht Opus 5.5.
Der Haken: Fable frisst dein Kontingent schneller. Im Pro-Abo ist es nur zum Start dabei (bis 16. November, für maximal die Hälfte deines Wochenlimits).
Unser Take: Das beste Modell, aber nur für dicke Bretter 👍
Fable 5.2 ist magisch und wir halten es für das beste Modell aktuell. Es ist schnell und sieht Dinge, die bei uns wochenlang untergegangen sind. Aber die Aufgaben müssen anspruchsvoll genug sein.
🧠 Ein Gehirn für alle deine Agents kinderleicht aufgesetzt
Wir haben mittlerweile ein kleines Agenten-Problem.
Claude Code für das Second Brain. Ein Grok-Bot-Team für die Arbeit. Seit letzter Woche Claude Duet. Und ChatGPT mischt auch manchmal mit.
Alle richtig gut. Aber keiner weiß, was der andere weiß. Da verliert man schnell den Überblick.
Wir glauben, dass jeder von uns in Zukunft mit ganzen Agent-Teams arbeiten wird (wenn nicht eh schon). Dann wird es umso wichtiger, dass alle denselben Stand haben.
Hier gibt es natürlich verschiedenste Möglichkeiten, das zu lösen. Letzte Woche haben wir hier einen Deep Dive dazu geschrieben.
Heute mal die einfachste von allen:
Viele Jahre haben wir Notion intensiv genutzt, in letzter Zeit aber definitiv weniger.
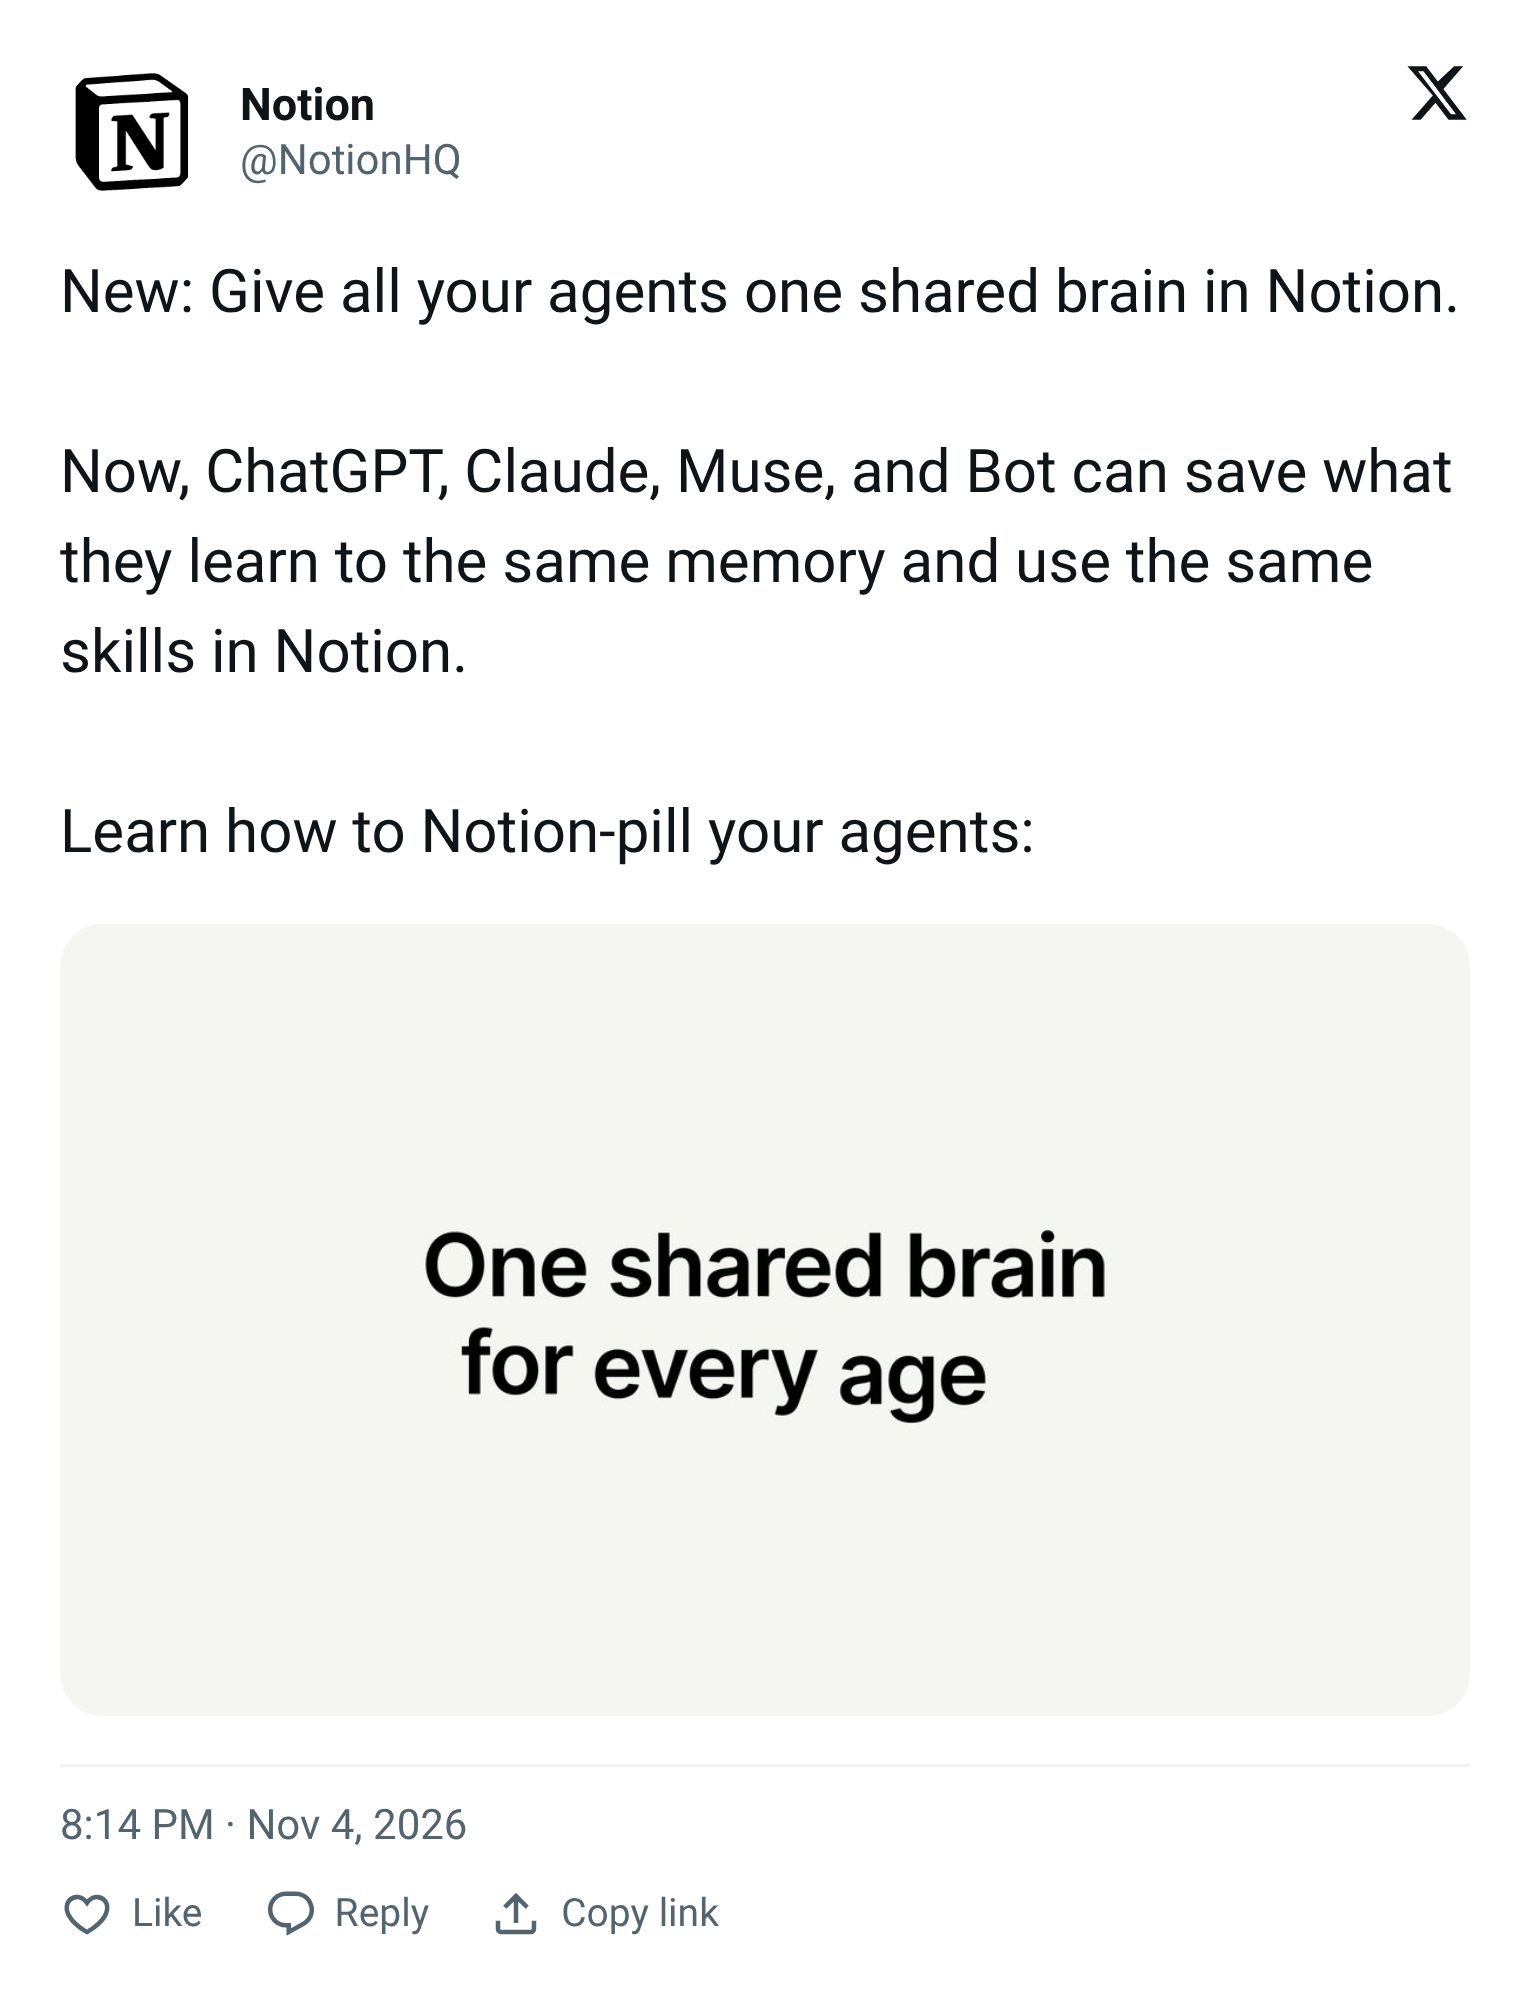
Letzte Woche haben sie aber ein Feature rausgehauen, das wirklich cool ist: ein gemeinsames Gedächtnis für alle deine Agents. ChatGPT, Claude und Co. speichern, was sie lernen, am selben Ort. Und lesen es auch von dort.
Das Schöne dabei: Es ist in 2 Minuten aufgesetzt!
Grok schreibt, Claude findet
Wir haben einen eigenen Notion-Workspace nur für die Agents angelegt.
Dann Claude und Grok Bot mit Notion verbunden und Notions Setup-Prompt laufen lassen.
Der richtet eine Art Hausordnung ein, die jeder Agent zuerst liest.
Dann der Test: Grok Bot speichert eine Entscheidung in Notion.
Und ein ganz neuer Claude-Chat bekommt nur die Frage, was wir heute entschieden haben.

Claude hat von selbst in Notion nachgeschaut, Groks Eintrag gefunden und sogar dazugeschrieben, dass Grok Bot ihn angelegt hat.
Zwei Agents, zwei Anbieter, derselbe Stand. Ohne dass die beiden je miteinander geredet haben.
Das ist uns lieber als Agents, die sich gegenseitig Nachrichten schicken. Aber das ist eine längere Geschichte (siehe Deep Dive).
Super einfach und immer online.
So startest du

In Notion einen neuen, leeren Workspace anlegen. Free Plan reicht.
In Claude oder ChatGPT den Notion-Konnektor verbinden. Workspace prüfen!

Diesen Prompt schicken:
Richte Notion als gemeinsames Gedächtnis für meine Agents ein. Folge dieser Anleitung: https://developers.notion.com/prompts/setup

Ich habe nur den Workspace „[NAME]“ verbunden, arbeite ausschließlich dort. Zeig mir vor dem Import, was du übernehmen willst, und importiere nur, was ich einzeln freigebe.

Private und finanzielle Themen bleiben draußen.
Wichtig: Der Agent will erst mal alles über dich wissen und vorschlagen, es rüberzukopieren. Gib lieber klein frei und zieh später nach.
Unser Take: Gleicher Stand schlägt Dauer-Chat
Wir glauben, die Agents müssen gar nicht ständig miteinander reden. Sie brauchen vor allem denselben Stand.
Notion ist dafür gerade der einfachste Weg. Wer schon mit Ordnern und Files over Tools arbeitet, braucht es nicht unbedingt. Aber es macht Spaß.
🎯 Klein schlägt groß: Das 57-Dollar-Modell
Oben haben wir das dickste Modell, das es gerade gibt, auf unsere Projekte und Werbeanzeigen losgelassen.
Kommen wir zum Abschluss zum genauen Gegenteil.
Das kleine Team von loglog.ai hat sich X einfach als Simulation nachgebaut, samt Nutzern, Werbekunden und der Anzeigen-Auktion.
Darin haben sie ein kleines, frei verfügbares Modell (DeepSeek V4.1 Flash) nur auf eine einzige Sache trainiert, nämlich Werbeanzeigen auf X zu schalten.
Das Training hat schlappe 57 Dollar gekostet. Und danach lag es in ihrer Simulation sogar vor Gemini, GPT, Grok und Claude Opus! Aber eben nur auf den Bereich X-Werbeanzeigen bezogen.

Nicht das erste Mal
Shopify-Chef Tobi Lütke hat im September etwas Ähnliches gezeigt.
Ein winziges Modell, das bei Shopify Käuferprofile erstellt. Bei genau dieser einen Aufgabe ist es besser als GPT-5.6 Sol, selbst wenn Sol auf der höchsten Denkstufe läuft.
Sprich: Es ist besser als eines der stärksten Modelle überhaupt. Und sogar noch schneller: 72 Millionen Profile am Tag statt 2 Millionen mit dem alten Modell.

Im Grunde läuft das immer gleich ab. Ein großes Modell macht es vor und ein kleines übt nur diese eine Sache, bis es sie besser und viel billiger kann.
Bevor du jetzt dein Abo kündigst
Nur diese eine Aufgabe. Sobald etwas anders aussieht als im Training, ist so ein kleines Modell schnell raus. Dein großes Modell brauchst du also weiterhin.
Die Zahlen kommen von loglog selbst. Und sie stammen aus ihrer eigenen Simulation. Erste echte Tests auf X nennen sie selbst „ernüchternd“.
Lohnt sich erst bei Masse. Shopify macht das für Millionen Aufrufe am Tag. Für 20 Mails die Woche eher nicht.
Unser Take: Groß für alles, klein für eine Sache
Wahrscheinlich wird es so sein, dass die Frontier-Anbieter einfach nahezu alles super hinbekommen und das passende Modell automatisch wählen.
Trotzdem halten wir den Ansatz kleiner, trainierter Open-Source-Modelle für sehr spannend.
Vielleicht könnte man auch einfach einem großen Modell sagen: Such dir die Daten und trainiere ein Open-Source-Modell darauf. 😉
Zum Nachmachen ist das für die meisten noch nichts. Aber vielleicht wird es einmal relevant, wenn es um Kosten, Autonomie etc. geht.
So, wir sind wieder durch für heute.
Falls du den Prompt aus dem Vibe Check auf deine eigenen Projekte loslässt, schreib uns gerne, was dabei rauskam. Auch wenn es weh tut. 😉
Danke fürs Lesen!
Reto & Fabian von den AInauten
⭐️ Wie hat dir diese Ausgabe gefallen?
Anmelden oder abonnieren teilnehmen
